
AI動画合成:複数の画像を1本の動画に
2〜3枚の画像をアップロード—AIが2〜3分で1つのダイナミックな動画に融合。
参照画像から動画生成AIとは?
参照画像から動画生成AIは、2〜3枚の個別画像を読み取り、1つのまとまりあるシーンとして動画化する生成AIです。手動合成が必要な従来の動画編集とは異なり、空間関係、照明条件、視点を自動的に理解し、複数の要素が同じショット内で自然に関わる動画を作成します。 この仕組みにより、高額な撮影や複雑な3Dレンダリングに頼らず、商品画像、モデル写真、背景ロケーションからマーケティング映像を2〜3分で試作できます。Googleの Veo 3.1 Fast モデルを搭載し、照明適応、奥行き知覚、リアルなモーション生成を自動的に処理します。
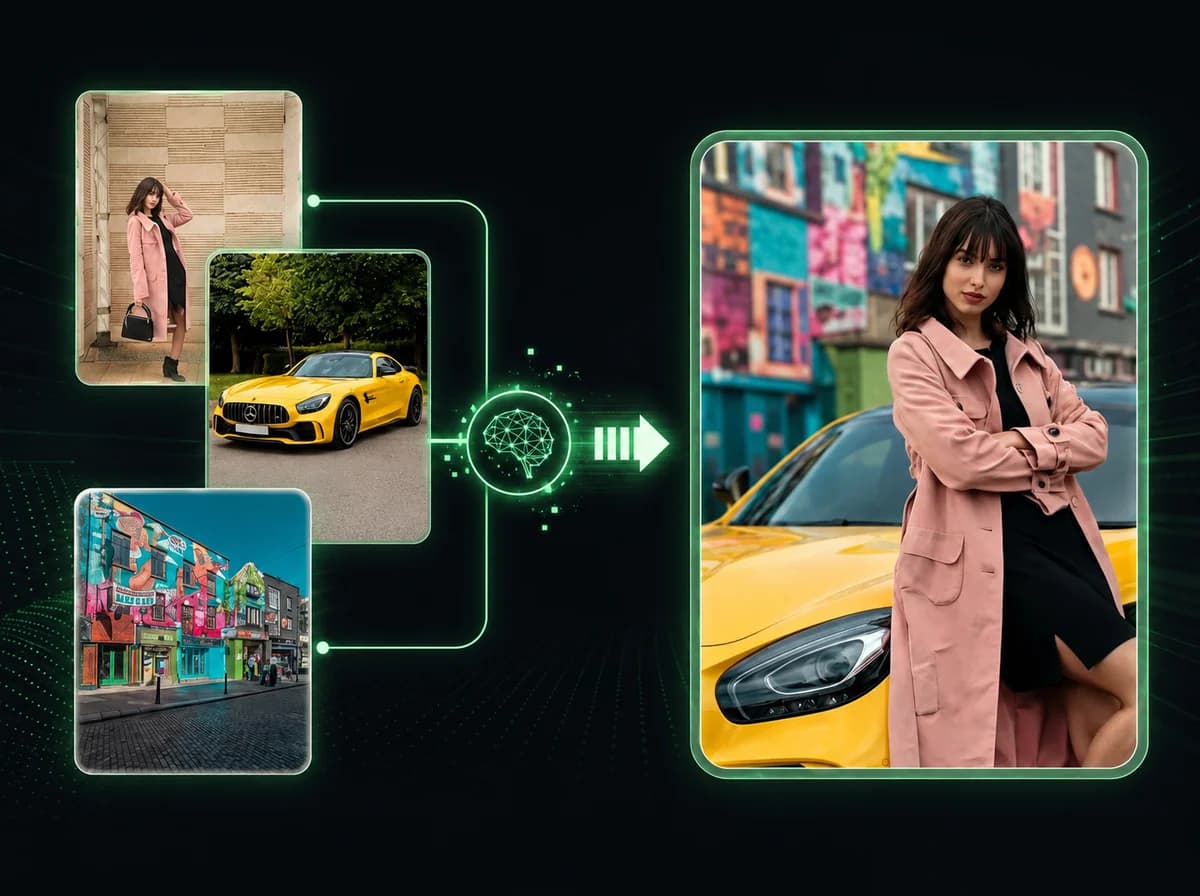
4つの簡単なステップでマルチ要素動画を作成
別々の画像からのAI駆動シーン合成
異なる要素をアップロード
異なる被写体の画像を2〜3枚選択 — 商品、人物、背景、または融合したい任意の組み合わせ。
シーンを説明
これらの要素がどのように相互作用するかを説明する指示文を作成します。例:「夕日のビーチでハンドバッグを持つ女性」。
AI融合
Veo 3.1 Fastが全ての要素を自然な照明と奥行きで1つのまとまりのある動画に融合。2〜3分で完了。
ダウンロード&共有
合成された動画をプレビューし、透かしなしの高品質版をダウンロード。マーケティングやソーシャルメディアに対応。
マルチ要素シーン合成
2〜3枚の異なる画像をアップロードすると、AIがそれらを1つのまとまりのあるシーンに融合。商品デモ、マーケティング動画、クリエイティブなストーリーテリングに最適。
超高速動画生成
Veo 3.1 Fast搭載で、2〜3分でプロフェッショナルな結果を提供。即座のプレビューと迅速な反復。

プロフェッショナル品質の出力
驚異的なリアリズムを持つ映画グレードの動画を生成。AIが適切な奥行き、照明、動きで自然な統合を確保。
指示文駆動の融合コントロール
詳細な指示文で要素の組み合わせ方を正確に指示。AIがビジョンを解釈し、シーン内で要素を自然に配置。
クリエイターが語る参照動画 AI

Jake H.
EC マネージャー
商品写真、モデル写真、背景をアップロードすれば、すぐにライフスタイル広告が完成。撮影不要です。販売ページがかなりプロフェッショナルになりました。

Sophia R.
ミュージックビデオディレクター
シンガーのポートレートとコンセプトアート、ロケーション参考画像を組み合わせます。実際の撮影前にシーンを視覚化するのに最適。プリプロダクションの時間が節約できます。

Marcus V.
ブランドストラテジスト
クライアントが製品を異なる環境で見たい場合、参照動画なら瞬時に作成できます。ロケテストごとにフォトグラファーを手配する必要がありません。

Emily T.
コンテンツクリエイター
自分の顔と服のインスピレーション、クールな背景をミックス。目立つユニークなコンテンツを作成できます。一般的なストックフッテージよりはるかに良いです。

David L.
インディーゲーム開発者
キャラクターアート、環境スケッチ、ライティング参照をブレンドしてゲームプレイプレビューに。完全なゲームを作る前に投資家にアイデアをピッチできます。

Rachel K.
ファッションデザイナー
服のデザイン、モデル写真、ランウェイの背景を組み合わせて、即座にファッションショーの映像が完成。クライアントは制作に入る前にビジョンを確認できます。

Chris P.
広告クリエイティブ
製品画像とシーン参照を組み合わせて製品配置をテストします。より速い反復により、より良いキャンペーン結果が得られます。クライアントの承認もスムーズになりました。
よくある質問
参照画像から動画AI生成について知っておくべきすべて
1参照画像から動画AI生成とは何ですか?
参照画像から動画では、2〜3枚の別々の画像(商品、人物、場所など)をアップロードすると、AIがそれらを1つのまとまりのある動画に融合します。複数の要素を自然に組み合わせる必要があるマーケティングコンテンツ、商品デモ、クリエイティブなストーリーテリングの作成に最適です。
2何枚の画像をアップロードできますか?
異なる被写体の画像を2〜3枚アップロードします。例:ハンドバッグ、モデル、ビーチの背景。AIは指示文の説明に基づいてインテリジェントに融合します。
3生成にはどのくらい時間がかかりますか?
ほとんどの動画は2〜3分で完成します。リアルタイムの進捗更新が表示され、合成された動画をすぐにプレビューできます。
4これらの動画を商用利用できますか?
はい、生成されたすべての動画は商用利用可能です。完全な権利を保持します。アップロードするすべての画像の権利を所有または持っていることを確認してください。
5どのようなタイプの画像が最適ですか?
明瞭で高解像度、良好な照明の画像を使用してください。最良の融合結果を得るには、クリーンな背景または明確な被写体の画像が必要です。過度にフィルター処理された画像やぼやけた画像は避けてください。
6要素の組み合わせ方をどのように制御しますか?
詳細な指示文を使用して、要素がどのように相互作用すべきかを正確に説明します。例:「夕日のビーチを歩きながら赤いハンドバッグを持つ女性」。指示文が具体的であるほど、結果が良くなります。
7参照画像から動画生成とテキストから動画生成の違いは?
テキストから動画生成はテキスト説明のみから動画を生成しますが、参照画像から動画生成は実際の画像を視覚ガイドとして使用します。参照画像から動画生成では、商品の外観、人物の顔、正確な背景など、特定の要素をより正確に制御でき、より正確で予測可能な結果が得られます。
8異なるアスペクト比を使用できますか?
はい。16:9(横向き)、9:16(縦向き、TikTok/Reels用)、1:1(正方形、Instagram用)、4:3、3:4、21:9、9:21から選べます。生成設定で比率を選択してください。
9この機能を動作させているAIモデルは?
参照画像から動画生成は、マルチ画像融合と高速生成に特化して最適化されたGoogle Veo 3.1 Fastモデルを搭載しています。Veo 3.1は空間関係の理解と、別々の要素間の自然な相互作用の作成に優れています。
10最良の結果を得るには?
最適な結果を得るために:(1) 高解像度画像(最低1024px)を使用、(2) 明確な被写体と良好な照明の画像を選択、(3) 要素の相互作用を説明する詳細な指示文を作成、(4) 互換性のある照明スタイルの画像を確保、(5) 過度に圧縮されたまたはぼやけた元画像を避ける。